
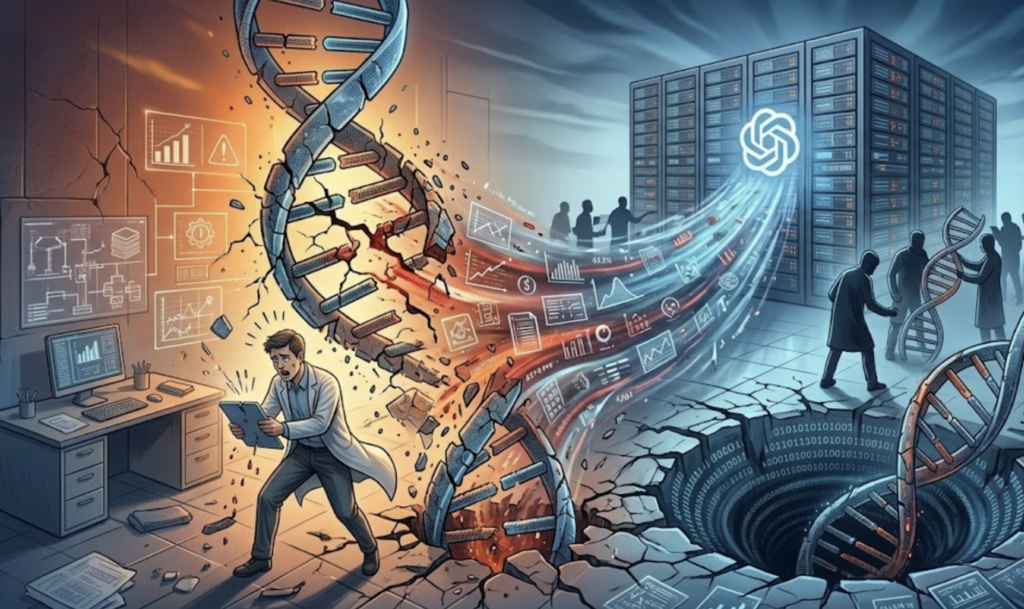
Có một khoảnh khắc mà bất kỳ nhà nghiên cứu nào dùng AI công cộng cũng nên dừng lại để suy nghĩ — không phải khi họ đang nhập dữ liệu nhạy cảm vào hộp chat, mà là khoảnh khắc ngay trước đó, khi họ nhìn vào màn hình và chuẩn bị nhấn Enter. Trong khoảnh khắc đó, câu hỏi cần được đặt ra không phải là ‘AI có cho tôi câu trả lời đúng không’ — mà là ‘dữ liệu này đi đến đâu sau khi tôi gửi nó đi.’
Câu hỏi đó hiếm khi được đặt ra. Và sự im lặng đó đang có giá.
Trong vài năm gần đây, cộng đồng học thuật đã chứng kiến một làn sóng áp dụng AI vào nghiên cứu với tốc độ vượt xa tốc độ hình thành nhận thức về rủi ro. Những học giả thảo luận quy trình kiểm duyệt đồng nghiệp trong slide đính kèm gửi cho ChatGPT để ‘làm đẹp văn bản’. Những nghiên cứu sinh nhập dữ liệu phỏng vấn thô — bao gồm tên, vị trí địa lý, và ý kiến cá nhân của người tham gia nghiên cứu — vào các nền tảng AI công cộng để phân tích. Những nhà nghiên cứu y tế chia sẻ hồ sơ bệnh nhân ẩn danh không hoàn chỉnh với các mô hình thương mại để tìm kiếm mô hình. Không ai trong số họ có ý định xấu. Nhiều người trong số họ không nhận ra rằng mình vừa vi phạm cam kết đạo đức mà họ đã ký với ban đạo đức nghiên cứu của trường.
⚠ Mỗi lần bạn dán dữ liệu nghiên cứu vào một nền tảng AI công cộng, bạn đang thực hiện một hành động chuyển dữ liệu có thể không thể đảo ngược — cho dù giao diện trông vô hại đến mức nào.
I. Điều Gì Thực Sự Xảy Ra Khi Bạn Gửi Dữ Liệu Lên AI Công Cộng
Hầu hết người dùng không đọc điều khoản dịch vụ. Điều đó là sự thật được hiểu ngầm của kỷ nguyên số. Nhưng đối với học giả làm việc với dữ liệu nhạy cảm, việc không đọc những điều khoản đó không phải là sự bất tiện nhỏ — nó là một lỗ hổng đạo đức và pháp lý nghiêm trọng.
Để hiểu tại sao, cần phân biệt ba loại rủi ro khác nhau mà hầu hết các cuộc thảo luận về ‘AI và quyền riêng tư’ gộp lại thành một: rủi ro lưu trữ, rủi ro đào tạo, và rủi ro suy luận. Rủi ro lưu trữ là khả năng dữ liệu bạn gửi được lưu trữ trên server của nhà cung cấp AI — ở đó nó có thể bị truy cập bởi nhân viên của họ, bị yêu cầu bởi cơ quan pháp lý, hoặc bị rò rỉ trong trường hợp vi phạm bảo mật. Rủi ro đào tạo là khả năng dữ liệu của bạn được sử dụng để cải thiện mô hình trong tương lai, điều này về lý thuyết có nghĩa là thông tin bạn gửi có thể xuất hiện trong phản hồi cho người dùng khác dưới một hình thức nào đó. Rủi ro suy luận là tinh tế nhất: ngay cả khi dữ liệu của bạn không bao giờ được lưu trữ hoặc đào tạo, chính thực tế là bạn đã truy vấn với dữ liệu đó — loại truy vấn gì, vào thời điểm nào, từ địa chỉ IP nào — tạo ra metadata có thể tiết lộ thông tin nhạy cảm về dự án nghiên cứu của bạn.
OpenAI, Anthropic, Google và các nhà cung cấp lớn khác đã cải thiện đáng kể chính sách quyền riêng tư của họ kể từ những ngày đầu. Nhiều trong số họ hiện cung cấp các cấp dịch vụ doanh nghiệp với các cam kết bảo mật mạnh hơn. Nhưng ngay cả với những cải thiện đó, có một điều mà bất kỳ chính sách quyền riêng tư nào của AI công cộng cũng không thể đảm bảo: rằng dữ liệu của bạn không bao giờ rời khỏi môi trường mà bạn kiểm soát. Bởi vì theo định nghĩa, khi bạn gửi dữ liệu đến server của người khác, bạn đã mất quyền kiểm soát đó.
II. Tình Huống Thực Tế: Khi Nào Thì Dữ Liệu Nghiên Cứu Là ‘Nhạy Cảm’
Một trong những nguồn gốc của hành vi rủi ro là sự không rõ ràng về những gì tạo nên dữ liệu nhạy cảm trong bối cảnh nghiên cứu học thuật. Nhiều học giả có hiểu biết trực quan đúng rằng số An sinh xã hội hay hồ sơ y tế cần được bảo vệ — nhưng lại ít nhận thức hơn về các loại nhạy cảm khác phát sinh cụ thể trong bối cảnh nghiên cứu.
Dữ liệu phỏng vấn và nhóm tập trung là một ví dụ quan trọng. Ngay cả khi transcript đã được ẩn danh hóa — tên được thay thế bằng mã, địa điểm được làm mờ — một mô hình AI tinh vi có thể suy ra danh tính từ sự kết hợp của chi tiết nghề nghiệp, quan điểm chính trị, và trải nghiệm cụ thể được mô tả trong phỏng vấn. Điều này đặc biệt đúng trong các cộng đồng nhỏ, nơi một số lượng nhỏ các đặc điểm nhận dạng đủ để xác định một người. Đây là bài kiểm tra: nếu bạn đọc transcript đó và có thể đoán ra ai là người nói, thì một mô hình được đào tạo trên dữ liệu cộng đồng đó cũng có thể đoán được.
Dữ liệu nghiên cứu chưa công bố là loại nhạy cảm khác thường bị bỏ qua. Kết quả thử nghiệm lâm sàng chưa được công bố, phát hiện sơ bộ từ nghiên cứu tài trợ, bản thảo trước khi được xem xét đồng nghiệp — những điều này thường bị kiểm soát bởi thỏa thuận tài trợ, giao thức đạo đức nghiên cứu, hoặc các thỏa thuận không tiết lộ với đối tác công nghiệp. Khi dữ liệu đó được chia sẻ với nền tảng AI thương mại, người dùng có thể đang vi phạm những thỏa thuận đó ngay cả khi dữ liệu không bao giờ trở thành một phần trong quá trình đào tạo.
Câu hỏi nghiên cứu nhạy cảm về mặt chính trị tạo thành loại thứ ba. Nhà nghiên cứu làm việc về phong trào ly khai, tổ chức thiểu số, hoặc phê bình chính phủ ở các môi trường có tính kiểm duyệt cao cần nhận ra rằng metadata của truy vấn của họ — các chủ đề họ nghiên cứu, các tài liệu họ phân tích, những người phỏng vấn họ tham khảo — có thể là nhạy cảm ngay cả khi nội dung riêng lẻ thì không. Trong bối cảnh này, không có điều khoản dịch vụ nào của công ty AI công cộng cung cấp bảo vệ đầy đủ, vì các công ty này chịu sự điều chỉnh của pháp luật trong nhiều thẩm quyền pháp lý khác nhau và có thể được yêu cầu tiết lộ dữ liệu người dùng theo lệnh pháp lý.
Vấn đề không phải là AI có độc hại không. Vấn đề là cơ sở hạ tầng AI công cộng được thiết kế để phục vụ hàng triệu người dùng — không phải để bảo vệ dữ liệu của một nhà nghiên cứu cụ thể trước những rủi ro cụ thể của họ.
III. Đạo Đức Học Thuật Trong Kỷ Nguyên AI: Lỗ Hổng Chưa Được Lấp Đầy
Hầu hết các hướng dẫn đạo đức nghiên cứu hiện có — từ Tuyên bố Belmont đến Quy tắc Chung của Hoa Kỳ đến các giao thức GDPR của châu Âu — được viết trong một thế giới mà ‘dữ liệu rời khỏi cơ sở nghiên cứu’ có nghĩa là dữ liệu vật lý được chuyển từ tủ tài liệu sang xe tải lưu trữ. Thực tế kỹ thuật số của việc gửi dữ liệu lên hộp chat AI trong vài giây là thứ mà những framework đó chưa bắt kịp.
Điều này tạo ra một vùng xám pháp lý và đạo đức mà các học giả thường thấy mình trong đó. Hội đồng đánh giá thể chế (IRB) thường chấp thuận các giao thức dữ liệu được thiết kế trước khi AI công cộng tồn tại. Thỏa thuận đồng ý cung cấp thông tin của người tham gia thường không đề cập đến việc dữ liệu của họ có thể được xử lý bởi các mô hình AI thương mại. Điều này đặt nhà nghiên cứu vào tình huống pháp lý kỳ lạ: họ có thể tuân thủ hoàn toàn thư pháp luật của giao thức đã được phê duyệt trong khi vi phạm tinh thần của những cam kết mà người tham gia đã được đưa ra.
Có những trường hợp trong đó sự vi phạm đó có hậu quả pháp lý có thể đo lường được. Quy định Bảo vệ Dữ liệu Chung của Châu Âu (GDPR) áp đặt các yêu cầu nghiêm ngặt về việc chuyển giao dữ liệu cá nhân của công dân EU cho các bên thứ ba — bao gồm cả nhà cung cấp AI. Việc gửi ngay cả dữ liệu ẩn danh một phần của người tham gia EU đến một công ty AI Mỹ không có cơ chế Khung Bảo vệ Dữ liệu phù hợp về mặt kỹ thuật là vi phạm GDPR — vi phạm đó có thể đi kèm với tiền phạt lên đến 4% doanh thu toàn cầu hàng năm của tổ chức, hoặc 20 triệu euro, tùy theo mức nào cao hơn. Không có trường đại học nào muốn tìm hiểu xem các cơ quan quản lý có muốn áp dụng hình phạt đó cho việc nhập liệu AI bất cẩn không.
IV. Sự Cố Stanford, Amsterdam, và Những Gì Chúng Ta Học Được
Vào tháng 4 năm 2023, Samsung Electronics đã trở thành câu chuyện kinh doanh đầu tiên được lưu hành rộng rãi về việc rò rỉ dữ liệu độc quyền qua ChatGPT — trong đó nhân viên đã chia sẻ mã nguồn nội bộ nhạy cảm và biên bản cuộc họp với mô hình. Nhưng trong thế giới học thuật, những sự cố ít được chú ý hơn đã xảy ra âm thầm hơn. Các giáo sư tại các trường đại học nghiên cứu lớn ở Mỹ và Châu Âu đã báo cáo các trường hợp trong đó bản thảo luận án chưa công bố với dữ liệu độc quyền đã được chia sẻ với các nền tảng AI công cộng trong quá trình chỉnh sửa — tạo ra sự không chắc chắn về việc liệu dữ liệu đó có được sử dụng trong đào tạo mô hình hay không và liệu nó có thể xuất hiện trở lại trong phản hồi của mô hình cho người dùng khác hay không.
Câu chuyện đáng lo ngại hơn từ cộng đồng học thuật đến từ các nhà nghiên cứu làm việc trong các môi trường pháp lý và chính trị phức tạp. Nhà nghiên cứu nghiên cứu các cộng đồng dễ bị tổn thương — người di cư không có giấy tờ, nhà hoạt động trong các nhà nước độc tài, người tố giác trong các tổ chức có nguồn lực — có nghĩa vụ bảo vệ đặc biệt đối với những người tham gia của họ. Khi dữ liệu về những người đó tồn tại trên server của công ty tư nhân phải tuân theo luật tiết lộ bắt buộc trong nhiều thẩm quyền, nguy cơ tiềm tàng của việc tiết lộ danh tính là thực. Đây không phải là kịch bản lý thuyết: đây là kiến trúc cơ sở hạ tầng hiện tại.
Điều các trường hợp này minh họa là sự chênh lệch cơ bản giữa tốc độ áp dụng công nghệ và tốc độ phát triển khung đạo đức để quản lý nó. Công nghệ di chuyển nhanh. Đạo đức học thuật, vốn phát triển thông qua sự đồng thuận và phê duyệt thể chế, di chuyển chậm. Khoảng cách giữa hai tốc độ đó là nơi mà rủi ro sống.
V. Kiến Trúc Giải Pháp: Tại Sao ‘Cổng AI’ Riêng Thay Đổi Mọi Thứ
Hiểu được vấn đề là một nửa của giải pháp. Nửa còn lại là hiểu được những gì về mặt kỹ thuật là có thể và những gì thực tế có thể triển khai trong bối cảnh của một nhà nghiên cứu cá nhân hoặc một nhóm nghiên cứu nhỏ với nguồn lực hạn chế.
Mô hình ngôn ngữ lớn cục bộ (Local LLM) đã trải qua một cuộc cách mạng thầm lặng trong ba năm qua. Các mô hình như Llama 3 của Meta, Mistral, Gemma của Google, và Qwen của Alibaba hiện cung cấp hiệu suất cho nhiều tác vụ nghiên cứu ở mức đủ gần với các mô hình thương mại hàng đầu để trở thành sự thay thế thực tế cho nhiều trường hợp sử dụng — trong khi chạy hoàn toàn cục bộ trên phần cứng mà nhà nghiên cứu kiểm soát. Khi một mô hình chạy cục bộ, không có dữ liệu nào rời khỏi máy tính của bạn. Không có server nào của bên thứ ba nhận được dữ liệu. Không có điều khoản dịch vụ nào cần đọc. Không có rủi ro lưu trữ, đào tạo, hay suy luận từ phía nhà cung cấp.
Nhưng chạy Local LLM thô không phải là giải pháp hoàn chỉnh cho học giả. Thiếu một lớp quản lý — một ‘gateway’ — thực tế sử dụng bị hạn chế bởi những thứ như thiếu tính nhất quán trong prompt, không có cơ chế quản lý phiên làm việc dài, và không có cơ sở hạ tầng để chia sẻ quyền truy cập trong nhóm nghiên cứu một cách an toàn. Đây là nơi OpenClaw Gateway lấp đầy khoảng trống.
OpenClaw Gateway là lớp trung gian nằm giữa nhà nghiên cứu và mô hình ngôn ngữ — cho dù mô hình đó là local hoặc cloud. Ở chế độ cục bộ hoàn toàn, nó điều phối giao tiếp giữa giao diện người dùng và mô hình chạy trên cùng máy hoặc mạng nội bộ, cung cấp quản lý phiên, lịch sử, và khả năng chia sẻ nhóm — tất cả mà không có bit dữ liệu nào rời khỏi môi trường vật lý do nhà nghiên cứu kiểm soát. Điều này khác về mặt kiến trúc, không chỉ về mặt độ độ, so với sử dụng ChatGPT Enterprise hay Claude Team — những sản phẩm này cung cấp sự cải thiện bảo mật có thực nhưng vẫn đặt dữ liệu trên server của người khác.
Câu hỏi không phải là ‘nhà cung cấp AI này có đáng tin không.’ Câu hỏi là ‘tôi có thể chấp nhận kiến trúc trong đó dữ liệu nghiên cứu của tôi tồn tại ở bất kỳ đâu ngoài môi trường tôi kiểm soát không.’ Đối với nhiều dự án nghiên cứu, câu trả lời đúng đắn là không.
VI. Phổ Rủi Ro: Cách Suy Nghĩ Về Quyết Định Nào Cần Tự Host
Tự host hoàn toàn không phải là câu trả lời đúng cho mọi tình huống. Có sự đánh đổi thực sự liên quan — về tài nguyên tính toán, về hiệu suất mô hình ở một số tác vụ chuyên môn, và về thời gian thiết lập. Câu hỏi thực hành là: làm thế nào để đánh giá rủi ro của dự án cụ thể của bạn đủ chính xác để đưa ra quyết định thông minh.
Ở một đầu của phổ là công việc không nhạy cảm với rủi ro thấp: tổng hợp tài liệu từ các bài báo đã công bố, dịch thuật văn bản học thuật đã công bố, phân tích ngữ pháp và phong cách của bản thảo không có dữ liệu người dùng, hoặc tạo ra các câu hỏi phỏng vấn thông thường. Đối với những tác vụ này, sử dụng AI công cộng là hợp lý và tỷ lệ rủi ro-lợi ích nghiêng về phía lợi ích rõ ràng.
Ở đầu kia là những tình huống yêu cầu tự host hoặc ít nhất là triển khai đám mây riêng (private cloud): xử lý dữ liệu người tham gia từ các nhóm dễ bị tổn thương, phân tích tài liệu được bảo vệ bởi thỏa thuận bảo mật, làm việc với dữ liệu bệnh nhân hoặc lịch sử y tế ngay cả khi đã ẩn danh một phần, điều hành nghiên cứu phỏng vấn trong các môi trường chính trị nhạy cảm, và xử lý dữ liệu độc quyền trong nghiên cứu đối tác công nghiệp.
Phần khó là ở giữa — và đó là nơi hầu hết các dự án nghiên cứu thực sự rơi vào. Dữ liệu ẩn danh từ khảo sát lớn, phân tích văn bản từ nguồn mở nhưng kết hợp với metadata cá nhân, nghiên cứu so sánh chính sách sử dụng tài liệu chưa công bố. Đối với những trường hợp này, quyết định đúng đắn đòi hỏi sự đánh giá cẩn thận về các cam kết cụ thể được đưa ra với những người tham gia, về yêu cầu pháp lý của thẩm quyền nơi nghiên cứu được thực hiện, và về mức độ nhạy cảm mà một sự cố rò rỉ sẽ gây ra — không chỉ cho nhà nghiên cứu mà còn cho những người họ đang nghiên cứu.
VII. Hướng Dẫn Thực Tế: Xây Dựng Môi Trường AI An Toàn Cho Nghiên Cứu
Đối với học giả đã quyết định rằng dự án của họ yêu cầu triển khai cục bộ, quy trình thiết lập đã trở nên tiếp cận được đáng kể hơn so với ba năm trước. Đây không còn là lãnh thổ chỉ dành cho các kỹ sư hệ thống — mặc dù một số kỹ năng kỹ thuật vẫn cần thiết.
Lớp đầu tiên là chọn mô hình phù hợp với tác vụ và phần cứng của bạn. Llama 3.1 70B của Meta trong phiên bản quantized Q4 có thể chạy trên một máy với GPU tiêu dùng 24GB VRAM và cung cấp hiệu suất đủ cho hầu hết các tác vụ xử lý văn bản học thuật. Đối với phần cứng ít mạnh hơn, Llama 3.1 8B hoặc Mistral 7B cung cấp hiệu suất mạnh hơn ở mức lượng tử hóa thấp hơn. Điểm quan trọng là các mô hình này có thể chạy offline hoàn toàn — không cần kết nối Internet sau khi tải xuống.
Lớp thứ hai là triển khai OpenClaw Gateway giữa nhà nghiên cứu và mô hình. Trong cấu hình cục bộ hoàn toàn, Gateway chạy trên cùng máy hoặc mạng nội bộ, cung cấp giao diện thống nhất, quản lý phiên, và khả năng để nhiều thành viên trong nhóm nghiên cứu truy cập mô hình mà không ai cần thiết lập riêng của họ. Điều này có nghĩa là trưởng nhóm nghiên cứu có thể thiết lập một lần và cung cấp quyền truy cập được kiểm soát cho các thành viên nhóm — tương tự như việc cung cấp quyền truy cập vào cơ sở dữ liệu nghiên cứu an toàn.
Lớp thứ ba, thường bị bỏ qua, là tài liệu. Mỗi dự án sử dụng AI nên có một mục tiêu bảo vệ dữ liệu rõ ràng trong giao thức IRB của nó, mô tả cụ thể rằng xử lý AI xảy ra trên phần cứng do nhà nghiên cứu kiểm soát, không có dữ liệu nào được truyền đến các server bên ngoài, và mô hình nào đang được sử dụng. Điều này không chỉ là tuân thủ tốt — đó là bằng chứng bảo vệ bạn nếu câu hỏi về xử lý dữ liệu nảy sinh sau này.
Kết Luận: Sự Tiện Lợi Là Một Chính Sách
Khi học giả sử dụng AI công cộng cho dữ liệu nghiên cứu nhạy cảm, họ đang đưa ra một lựa chọn chính sách — ngay cả khi họ không coi đó là vậy. Họ đang nói rằng sự tiện lợi của việc truy cập ngay lập tức vào mô hình hiệu suất cao quan trọng hơn những rủi ro được tạo ra bởi cơ sở hạ tầng bảo mật của kiến trúc đó. Đây có thể là sự đánh đổi đúng đắn đối với nhiều trường hợp sử dụng. Nhưng đó là sự đánh đổi nên được thực hiện một cách có ý thức, không phải mặc định.
Sự thay đổi cần thiết không phải là từ bỏ AI trong nghiên cứu — đó sẽ là phản ứng không cân xứng với vấn đề thực sự. Sự thay đổi cần thiết là từ bỏ giả định rằng tiện lợi và an toàn là tương thích trong mọi bối cảnh. Đôi khi họ có, đôi khi họ không. Nhà nghiên cứu có trách nhiệm chuyên môn và đạo đức để biết sự khác biệt.
Những người tham gia nghiên cứu tin tưởng các học giả với dữ liệu của họ vì họ đã được đảm bảo rằng dữ liệu đó sẽ được bảo vệ. Sự đảm bảo đó không kết thúc ở cổng vào của tòa nhà nghiên cứu. Nó kéo dài đến mỗi quyết định nhỏ được đưa ra về cách xử lý dữ liệu đó — bao gồm quyết định nhấn Enter sau khi dán nó vào hộp chat AI.
◉ 0 Thảo luận Khoa học