
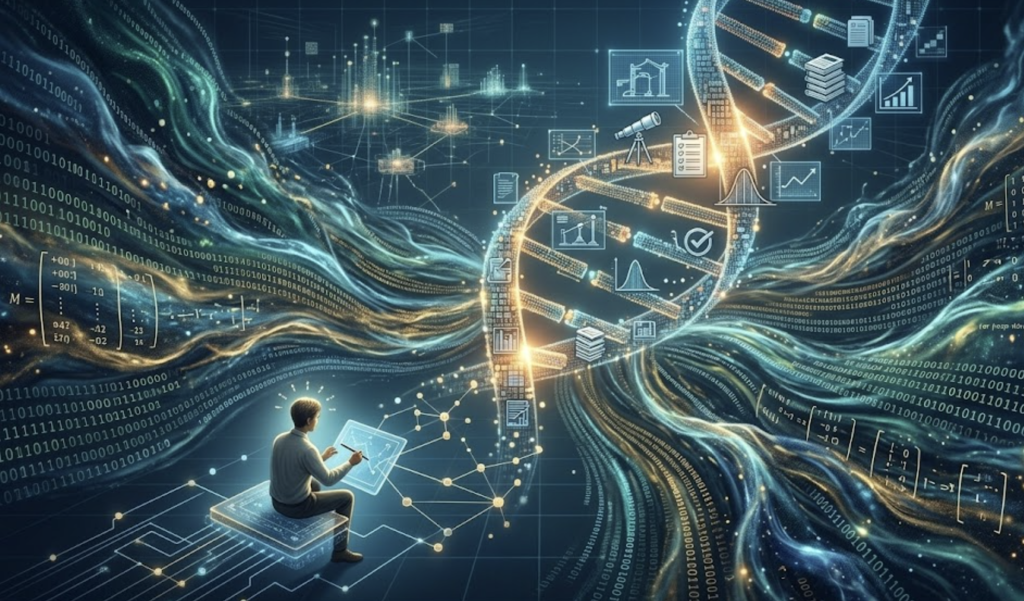
Mỗi thập kỷ, khoa học xã hội lại trải qua một cơn chấn động làm thay đổi hoàn toàn cách các học giả nhìn nhận nghề của mình. Những năm 1990 là cuộc cách mạng của thiết kế nghiên cứu cứng cáp khi Gary King, Robert O. Keohane và Sidney Verba xuất bản Designing Social Inquiry — một cuốn sách mà ngay cả những người phê phán nó cũng phải thừa nhận đã thay đổi cách cả một thế hệ nhà nghiên cứu suy nghĩ về bằng chứng và suy luận. Những năm 2020 là kỷ nguyên của Big Data, nơi hàng triệu điểm dữ liệu từ mạng xã hội, văn bản số hóa và hệ thống thông tin địa lý có thể được thu thập và phân tích trong tích tắc.
Điều nguy hiểm nhất trong thời đại này không phải là thiếu dữ liệu — mà là thừa dữ liệu nhưng thiếu tư duy. Khi bạn có thể khai thác hàng triệu tweet để nghiên cứu quan điểm chính trị, câu hỏi không còn là ‘tôi có đủ dữ liệu không’ mà là ‘tôi có đang đặt đúng câu hỏi không, tôi có đo đúng thứ tôi nghĩ tôi đang đo không, và những kết luận tôi rút ra có thực sự là nhân quả hay chỉ là tương quan may rủi.’ Đây là nơi bốn công trình kinh điển của KKV, W. Phillips Shively, Kosuke Imai và Martha Finnemore vẫn còn nguyên giá trị — không phải như những di vật học thuật, mà như những công cụ tư duy không thể thiếu.
Khủng hoảng lớn nhất của nhà nghiên cứu hiện đại không nằm ở chỗ thiếu dữ liệu, mà nằm ở những lỗ hổng trong logic suy luận mà một đại dương dữ liệu không thể lấp đầy.
I. Điểm Chạm Chung: Khi Định Lượng và Định Tính Nhìn Nhau Vào Mắt
Trong nhiều thập kỷ, khoa học xã hội tồn tại trong tình trạng phân ly ngầm giữa hai trường phái. Các nhà nghiên cứu định lượng coi phỏng vấn sâu và nghiên cứu điển hình là ‘kể chuyện’, thiếu tính tổng quát hóa. Các nhà nghiên cứu định tính coi hồi quy tuyến tính và kiểm định thống kê là công cụ thô bạo, bóp chết sự tinh tế của bối cảnh. Cả hai đều sai ở một điểm căn bản.
Đóng góp lớn nhất của King, Keohane và Verba không phải là một kỹ thuật hay một phương pháp cụ thể. Đó là lập luận rằng nghiên cứu định lượng và định tính, dù khác biệt về văn phong và công cụ, đều phải tuân thủ một logic suy luận khoa học nền tảng duy nhất. Mục tiêu tối thượng của cả hai không phải là thu thập sự kiện — mà là sử dụng những gì quan sát được để rút ra những suy luận đáng tin cậy về những quy trình và cấu trúc chưa quan sát được trong thế giới thực. Một nghiên cứu điển hình về cuộc khủng hoảng Cuba năm 1962 và một mô hình hồi quy về hành vi bầu cử ở 80 quốc gia đang cùng làm một việc — chúng chỉ sử dụng các công cụ khác nhau để làm nó.
Sự thống nhất này quan trọng vì nó đặt ra một tiêu chuẩn chung mà không ai được phép trốn tránh. Nhà nghiên cứu định tính không thể tự miễn cho mình khỏi yêu cầu phải suy nghĩ nghiêm túc về thiên lệch chọn mẫu chỉ vì họ làm điền dã. Nhà nghiên cứu định lượng không thể ẩn sau những con số và giả vờ rằng một mô hình thống kê tinh xảo tự nó là bằng chứng của quan hệ nhân quả.
Shively bổ sung vào bức tranh này một khái niệm có vẻ đơn giản nhưng thực ra cực kỳ sắc bén: tính thanh lịch của lý thuyết. Một lý thuyết tốt không phải là lý thuyết phức tạp nhất — đó là lý thuyết đơn giản nhất có thể giải thích hiện tượng quan tâm với độ chính xác dự báo cao nhất và có tầm quan trọng thực sự. Lý thuyết càng thanh lịch, nhà nghiên cứu càng có nhiều đòn bẩy — một biến số có thể giải thích nhiều hiện tượng hơn là điều đáng tìm kiếm hơn một lý thuyết muôn vàn biến số chỉ khớp với dữ liệu đã có. Trong thời đại machine learning có thể tạo ra các mô hình fit dữ liệu quá hoàn hảo, cảnh báo của Shively về việc đừng nhầm lẫn giữa fitting và explaining càng trở nên cấp thiết hơn bao giờ hết.
II. Mâu Thuẫn Khai Mở Nhận Thức: Khi Thực Chứng Gặp Kiến Tạo
Có một loại mâu thuẫn học thuật không phá hủy mà kiến tạo — khi hai lập trường không thể hòa giải nhau nhưng sự đối kháng của chúng lại buộc cả hai phía phải trở nên tinh tế hơn. Cuộc gặp gỡ giữa mô hình thực chứng của KKV và thuyết kiến tạo của Martha Finnemore là loại mâu thuẫn đó.
Finnemore tấn công vào một trong những giả định nền tảng ẩn bên dưới phần lớn lý thuyết quan hệ quốc tế: rằng lợi ích quốc gia — quyền lực, an ninh, thịnh vượng — là những thực thể bất biến, có trước khi có bất kỳ tương tác xã hội nào, giống như các hành tinh tồn tại trước khi có ai đặt tên cho chúng. Không đúng, Finnemore lập luận. Các quốc gia không biết họ muốn gì cho đến khi các cấu trúc xã hội quốc tế và các chuẩn mực quốc tế cho họ biết họ nên muốn gì. Lợi ích không phải là điều kiện ban đầu; chúng là kết quả của một quá trình kiến tạo xã hội liên tục.
Điều này không chỉ là tranh luận triết học. Nó có hệ quả trực tiếp với thiết kế nghiên cứu. Nếu lợi ích được kiến tạo xã hội thay vì bẩm sinh, thì việc đưa chúng vào mô hình như những biến số ngoại sinh (exogenous variables) — như hầu hết các mô hình định lượng vẫn làm — là một lỗi sai về mặt bản thể luận, không phải chỉ là kỹ thuật.
Căng thẳng giữa KKV và Finnemore còn bùng phát ở một điểm kỹ thuật cụ thể: cạm bẫy chọn mẫu trên biến phụ thuộc. KKV cảnh báo nghiêm khắc rằng nếu bạn chọn các trường hợp nghiên cứu dựa trên kết quả đầu ra (biến phụ thuộc), bạn sẽ không bao giờ học được điều gì về nguyên nhân thực sự. Nếu bạn chỉ nghiên cứu các cuộc cách mạng thành công để tìm hiểu nguyên nhân của cách mạng, bạn đã loại bỏ khỏi mẫu tất cả những trường hợp các điều kiện tương tự tồn tại nhưng cách mạng không xảy ra. Suy luận của bạn sẽ bị bóp méo không thể phục hồi.
Finnemore không phủ nhận cảnh báo này — nhưng bà chỉ ra rằng nó chỉ đúng trong một ngữ cảnh cụ thể: khi bạn đang kiểm định lý thuyết. Khi bạn đang ở giai đoạn kiến tạo lý thuyết, đặc biệt khi đối mặt với những hiện tượng mà chính sự đồng nhất của chúng là điều cần giải thích — tại sao tất cả các quốc gia, bất kể văn hóa và lịch sử, đều đột ngột xây dựng các cơ cấu quan liêu khoa học giống hệt nhau vào nửa sau thế kỷ 20 — thì việc nghiên cứu chính sự đồng nhất đó là bước đi hợp lý đầu tiên để tạo ra câu hỏi nghiên cứu. Phương pháp phải phục vụ lý thuyết, không phải bóp nghẹt trí tưởng tượng khoa học.
Lý thuyết không phải là thứ bạn chứng minh sau khi thu thập đủ dữ liệu. Lý thuyết là thứ quyết định bạn sẽ nhìn vào đâu, đặt câu hỏi gì, và coi cái gì là bằng chứng.
III. Bốn Cạm Bẫy Chí Mạng Trong Thiết Kế Nghiên Cứu
Sau hàng chục năm đọc bản thảo luận án tiến sĩ và bài báo khoa học xã hội, người ta bắt đầu thấy những mô hình lỗi lặp đi lặp lại. Không phải vì các nghiên cứu sinh thiếu thông minh — mà vì những cạm bẫy này ẩn mình rất khéo léo và đôi khi trông như những quyết định hoàn toàn hợp lý cho đến khi ai đó chỉ ra vấn đề.
Cạm bẫy đầu tiên là thiết kế nghiên cứu bất định — khi số lượng suy luận cần rút ra lớn hơn số lượng quan sát thực sự có. Nhiều luận án mắc phải tình trạng: 12 biến số giải thích, 15 trường hợp nghiên cứu, và tham vọng giải thích toàn bộ chính sách đối ngoại của một khu vực. Không một phương pháp thống kê hay định tính nào có thể tách rời được sự đóng góp của từng biến trong điều kiện đó. Kết quả là nhà nghiên cứu phải viết những đoạn như ‘kết quả gợi ý rằng’ hoặc ‘có thể lập luận rằng’ — những cụm từ nghe rất học thuật nhưng thực ra là tín hiệu của một thiết kế không đủ sức trả lời câu hỏi đặt ra.
Cạm bẫy thứ hai tinh tế hơn: đo lường hời hợt các khái niệm đa chiều. Shively chỉ ra rằng ngôn ngữ đời thường là nguồn gốc của nhiều nhầm lẫn học thuật nhất. Khi ai đó nói ‘quyền lực’, họ có thể đang nói về ít nhất năm thứ khác nhau: khả năng ép buộc quân sự, ảnh hưởng kinh tế, quyền lực mềm văn hóa, quyền lực thiết lập nghị sự, và khả năng kiến tạo chuẩn mực quốc tế. Ép tất cả năm chiều này vào một biến số duy nhất rồi chạy hồi quy không phải là đo lường — đó là ẩn dụ được ngụy trang thành khoa học. Trước khi thu thập bất kỳ dữ liệu nào, nhà nghiên cứu phải dành thời gian để bóc tách các chiều kích của khái niệm trung tâm và quyết định chiều nào thực sự liên quan đến câu hỏi nghiên cứu của mình.
Cạm bẫy thứ ba là cặp đôi nguy hiểm của nội sinh và biến bị bỏ sót. Nội sinh xảy ra khi biến bạn cho là nguyên nhân thực ra cũng bị tác động ngược bởi chính kết quả bạn đang cố giải thích. Một ví dụ kinh điển: bạn muốn chứng minh rằng dân chủ thúc đẩy tăng trưởng kinh tế, nhưng thực ra tăng trưởng kinh tế cũng làm cho dân chủ bền vững hơn — chiều quan hệ chạy theo cả hai hướng, và mô hình của bạn không phân biệt được. Biến bị bỏ sót lại còn nguy hiểm hơn vì nó vô hình: một yếu tố thứ ba có ảnh hưởng đến cả nguyên nhân lẫn kết quả mà bạn không đưa vào mô hình sẽ làm cho hệ số ước lượng của bạn bị lệch một cách có hệ thống mà bạn không biết.
Cạm bẫy thứ tư — thiên lệch chọn mẫu — là lỗi mà cả những nhà nghiên cứu kinh nghiệm vẫn có thể mắc phải, đặc biệt khi làm việc với dữ liệu lưu trữ. Nếu bạn chỉ phỏng vấn những người bỏ phiếu để nghiên cứu quyết định bầu cử, bạn đã loại bỏ khỏi mẫu chính những người mà lý do không bỏ phiếu của họ có thể là thông tin quan trọng nhất. Nếu bạn chỉ nghiên cứu các cuộc đàm phán ngoại giao có trong hồ sơ giải mật, bạn đang nghiên cứu tập hợp con những gì chính phủ quyết định cho bạn xem — không phải những gì thực sự xảy ra. Dữ liệu bị kiểm duyệt không phải là dữ liệu ngẫu nhiên; nó bị kiểm duyệt theo những quy tắc có hệ thống thường liên quan đến chính biến phụ thuộc của bạn.
IV. Big Data, Trí Tuệ Nhân Tạo, và Câu Hỏi Mà Máy Móc Không Thể Trả Lời
Imai và Bougher đã chứng minh rằng khoa học xã hội định lượng hiện đại có thể xử lý những loại dữ liệu mà chỉ một thập kỷ trước là không tưởng: hàng triệu tweet, hàng chục nghìn văn bản chính sách được phân tích bằng xử lý ngôn ngữ tự nhiên, dữ liệu vệ tinh về hoạt động kinh tế, mạng lưới quan hệ xã hội với hàng tỷ cạnh. Đây là những bước tiến thực sự, và những nhà khoa học xã hội từ chối học những công cụ này đang tự loại mình ra khỏi một phần quan trọng của cuộc trò chuyện học thuật hiện đại.
Nhưng có một nghịch lý ẩn trong sự hào hứng với Big Data. Khi thuật toán machine learning có thể tìm ra hàng nghìn mô hình tương quan trong một bộ dữ liệu lớn, vấn đề không còn là khả năng tính toán — mà là khả năng phân biệt mô hình có ý nghĩa thực sự với nhiễu thống kê. Một mô hình có thể dự báo chính xác 95% kết quả trong tập dữ liệu huấn luyện và vẫn không cho bạn biết gì về cơ chế nhân quả tạo ra những kết quả đó. Tương quan không phải là nhân quả — đây không phải là câu nói sáo rỗng mà là một cảnh báo kỹ thuật cực kỳ cụ thể về giới hạn của suy luận thống kê.
Imai nhắc lại một điều mà KKV đã nói từ ba thập kỷ trước nhưng trở nên đúng hơn trong kỷ nguyên Big Data: lý thuyết mạnh không phải là thứ bạn xây dựng sau khi nhìn vào dữ liệu. Lý thuyết là thứ bạn phải có trước khi quyết định nhìn vào đâu. Nếu không có lý thuyết để định hướng, bạn không biết mô hình nào trong hàng nghìn mô hình mà máy tính tìm ra là thực và mô hình nào là artifact của dữ liệu. Thanh lịch lý thuyết của Shively, trong bối cảnh này, không phải là sở thích thẩm mỹ — đó là bộ lọc tồn tại cần thiết để không chết đuối trong đại dương dữ liệu.
Finnemore thêm một chiều sâu khác vào cuộc tranh luận này. Khi thuật toán được huấn luyện trên dữ liệu lịch sử để dự báo xung đột, nó đang mã hóa vào trong mô hình tất cả những thiên kiến hệ thống của lịch sử đó. Nếu lợi ích quốc gia được kiến tạo xã hội và thay đổi theo thời gian, thì một thuật toán học từ hành vi trong quá khứ không chỉ dự báo tương lai — nó còn có thể kiến tạo tương lai bằng cách xác nhận những kỳ vọng của chính nó. Đây là vấn đề không phải của kỹ thuật mà của triết học khoa học xã hội.
V. Năm Bước Xây Dựng Thiết Kế Nghiên Cứu Chuẩn Q1
Những nguyên tắc trên không phải là lý thuyết xa vời — chúng có thể được chuyển hóa thành thực hành cụ thể trong từng giai đoạn của dự án nghiên cứu. Sau đây là năm bước mà sự phân biệt giữa một bài báo bị từ chối và một bài báo được accept ở tạp chí Q1 thường được quyết định.
Bước đầu tiên là tìm kiếm sự dị thường thay vì xác nhận điều đã biết. Những đóng góp học thuật đáng nhớ nhất thường xuất phát từ một quan sát không khớp với lý thuyết hiện hành — không phải từ việc kiểm định lại một lý thuyết đã được kiểm định chục lần. Hãy đặt câu hỏi: điều gì trong thực tế quan sát được của tôi mâu thuẫn với những gì lý thuyết dòng chính dự đoán? Đó chính là điểm đòn bẩy để bạn có thể nói điều gì đó thực sự mới.
Bước thứ hai là giải phẫu khái niệm trước khi đụng đến dữ liệu. Lấy khái niệm trung tâm của nghiên cứu và liệt kê tất cả các chiều kích có thể của nó. Sau đó quyết định chiều nào thực sự liên quan đến cơ chế nhân quả bạn quan tâm, và thiết kế thước đo chỉ cho chiều đó. Một thước đo hẹp, rõ ràng, và có thể sai (falsifiable) bao giờ cũng tốt hơn một thước đo rộng, mơ hồ nhưng ‘toàn diện’.
Bước thứ ba là nhân bản quan sát theo chiều sâu thay vì chỉ chiều rộng. Khi không thể tăng số lượng trường hợp nghiên cứu, hãy chia nhỏ dữ liệu hiện có theo thời gian, theo cấp độ địa phương, hoặc theo các đơn vị phân tích nhỏ hơn. Một nghiên cứu về 10 quốc gia với dữ liệu 30 năm, chia theo tỉnh/bang, có thể cung cấp hàng nghìn quan sát thay vì 10 — và sức mạnh thống kê để phân tách các tác động.
Bước thứ tư là thiết kế để loại trừ các giải thích thay thế, không phải chỉ để xác nhận giả thuyết chính. Trước khi viết bất cứ điều gì, hãy liệt kê ba giải thích thay thế mạnh nhất cho kết quả dự kiến của bạn, và thiết kế nghiên cứu sao cho dữ liệu có thể phân biệt giữa giả thuyết của bạn và những giải thích đó. Một reviewer giỏi sẽ làm điều này cho bạn — tốt hơn là bạn làm trước.
Bước cuối cùng, và đây là điều mà các tạp chí hàng đầu ngày càng đòi hỏi: báo cáo độ bất định một cách trung thực và đầy đủ. Mọi ước lượng đều có sai số; mọi kết luận đều có điều kiện. Việc báo cáo khoảng tin cậy, phân tích độ nhạy, và thậm chí là các kết quả không có ý nghĩa thống kê không làm yếu nghiên cứu của bạn — nó làm tăng độ tin cậy và chống lại publication bias, căn bệnh đang dần bào mòn uy tín của khoa học xã hội.
Khoa học ở trạng thái tốt nhất của nó là một nỗ lực mang tính xã hội — không phải vì chúng ta đồng ý với nhau, mà vì chúng ta chia sẻ một cam kết chung với bằng chứng và lập luận cởi mở.
Kết: Tư Duy Phương Pháp Luận Là Thứ Duy Nhất Không Thể Thuê Ngoài Cho AI
Những cuốn sách của KKV, Shively, Imai và Finnemore không dạy bạn phần mềm. Chúng dạy bạn cách suy nghĩ — về bằng chứng, về suy luận, về giới hạn của những gì bạn có thể biết từ dữ liệu bạn có. Đây là loại tư duy mà không một thuật toán nào, không một công cụ AI nào hiện tại có thể thay thế, vì nó đòi hỏi sự hiểu biết về bối cảnh, về lý thuyết, và về những câu hỏi quan trọng với con người.
Kỷ nguyên Big Data không làm cho phương pháp luận trở nên lỗi thời. Nó làm cho phương pháp luận tốt trở nên khan hiếm và do đó có giá trị hơn bao giờ hết. Khi mọi người đều có thể truy cập vào cùng một bộ dữ liệu và chạy cùng một thuật toán, thứ phân biệt nghiên cứu xuất sắc với nghiên cứu tầm thường không phải là công cụ — mà là chất lượng của câu hỏi, sự chặt chẽ của thiết kế, và sự trung thực về những gì dữ liệu thực sự cho phép kết luận.
Hãy để dữ liệu lên tiếng. Nhưng hãy đảm bảo rằng bạn biết ngôn ngữ của nó đủ tốt để phân biệt tiếng nói thật với tiếng vọng.
◉ 0 Thảo luận Khoa học