
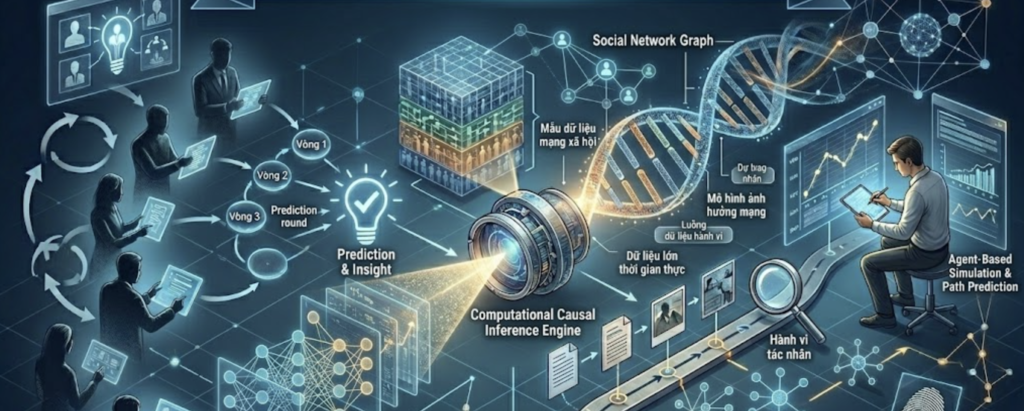
Năm 2009, David Lazer và các đồng nghiệp tại tạp chí Science đã công bố một bài báo tiên tri với tựa đề ‘Computational Social Science.’ Họ lập luận rằng sự bùng nổ của dữ liệu kỹ thuật số — từ email, điện thoại di động, mạng xã hội, và các hệ thống thông tin địa lý — đang tạo ra ‘kính viễn vọng mới’ cho nghiên cứu xã hội, có khả năng quan sát hành vi con người ở quy mô và độ phân giải mà không thể tưởng tượng được với các phương pháp truyền thống. Mười lăm năm sau, lời tiên tri đó đã trở thành thực tế — và kéo theo cả những thách thức mà bài báo đó chưa hoàn toàn dự đoán được.
Khoa học xã hội tính toán (Computational Social Science — CSS) là lĩnh vực học thuật nằm ở giao điểm của khoa học xã hội, thống kê, và khoa học máy tính. Không phải là sự thay thế của các phương pháp truyền thống, CSS là sự mở rộng của năng lực phân tích: khả năng xử lý dữ liệu ở quy mô hàng triệu và hàng tỷ quan sát, phát hiện các mô hình ẩn trong văn bản và mạng lưới, mô phỏng các hệ thống xã hội phức tạp, và kiểm định các lý thuyết xã hội với độ chính xác chưa từng có.
CSS không thay thế câu hỏi xã hội học hay câu hỏi chính trị học. Nó thay đổi tốc độ và quy mô tại đó ta có thể đặt ra và trả lời những câu hỏi đó.
PHẦN 1: Ba Trụ Cột Giao Thoa — Tại Sao CSS Cần Cả Ba Kỷ Luật
CSS không chỉ là khoa học xã hội sử dụng máy tính, cũng không chỉ là khoa học máy tính áp dụng cho dữ liệu xã hội. Sức mạnh và những thách thức của nó đến từ sự giao thoa thực sự giữa ba kỷ luật:
Từ Khoa học Xã hội: CSS thừa hưởng câu hỏi có ý nghĩa. Tại sao con người hình thành liên minh? Làm thế nào thông tin lan truyền? Không có nền tảng lý thuyết xã hội, nhà khoa học máy tính có thể phát hiện mô hình dữ liệu thú vị nhưng không biết phải diễn giải chúng như thế nào trong bối cảnh hành vi con người.
Từ Thống kê: CSS thừa hưởng kỷ luật suy luận. Mô hình có phù hợp tốt với dữ liệu không? Kết quả có tổng quát hóa được không? Không có kỷ luật thống kê, những mô hình phức tạp có thể che giấu những vấn đề suy luận cơ bản.
Từ Khoa học Máy tính: CSS thừa hưởng công cụ xử lý. Cách thu thập và làm sạch dữ liệu ở quy mô lớn, cách huấn luyện mô hình học máy, cách thiết kế mô phỏng tính toán. Không có năng lực kỹ thuật này, nhà nghiên cứu xã hội bị giới hạn trong tập dữ liệu con người có thể xử lý thủ công.
PHẦN 2: Bốn Trụ Cột Kỹ Thuật Của CSS
2.1 Phân Tích Mạng Lưới Xã Hội — Nhìn Thấy Cấu Trúc Ẩn
Phân tích mạng lưới xã hội (Social Network Analysis — SNA) nghiên cứu các thực thể xã hội như các nút trong một mạng và các mối quan hệ giữa chúng như các cạnh. Nguồn gốc của SNA bắt nguồn từ công trình của Jacob Moreno vào những năm 1930, nhưng việc áp dụng ở quy mô lớn chỉ trở nên khả thi khi sức mạnh tính toán đủ để xử lý các mạng lưới hàng triệu nút.
Các đại lượng đo lường trung tâm trong SNA bao gồm: độ trung tâm bậc (degree centrality — số lượng kết nối trực tiếp), độ trung tâm trung gian (betweenness centrality — tần suất một nút nằm trên đường đi ngắn nhất giữa hai nút khác), và độ trung tâm gần (closeness centrality — khoảng cách trung bình đến tất cả các nút khác). Những đại lượng này là các biến số có ý nghĩa lý thuyết về ảnh hưởng, quyền lực thông tin, và khả năng dễ bị tổn thương trong hệ thống.
Một ứng dụng mang tính chuẩn mực trong chính trị học là phân tích mạng lưới quan hệ đồng minh giữa các quốc gia. Cranmer và Desmarais (2011) trong Journal of Conflict Resolution đã sử dụng Exponential Random Graph Models để kiểm định liệu hành vi liên minh có bị ảnh hưởng bởi các đặc điểm song phương hay bởi các hiệu ứng mạng bậc cao hơn — câu hỏi mà các phân tích hồi quy truyền thống không thể trả lời.
2.2 Phân Tích Văn Bản và NLP — Đọc Hàng Triệu Tài Liệu
Xử lý ngôn ngữ tự nhiên (NLP) biến văn bản phi cấu trúc — bài phát biểu của chính trị gia, bình luận mạng xã hội, phán quyết tòa án — thành dữ liệu có thể định lượng và phân tích, mở ra toàn bộ thế giới nghiên cứu mà trước đây đòi hỏi đọc thủ công vô số tài liệu.
- Mô hình chủ đề (Topic Modeling): Các thuật toán như LDA phân loại corpus tài liệu lớn thành các chủ đề ẩn. Ứng dụng: phân tích sự tiến hóa nghị trình chính sách trong diễn văn quốc hội qua nhiều thập kỷ.
- Phân tích cảm xúc (Sentiment Analysis): Xác định sắc thái tình cảm trong văn bản để đo lường tình cảm công chúng theo thời gian thực.
- Mô hình ngôn ngữ lớn (LLMs) trong nghiên cứu: GPT-4, Claude và các mô hình tương tự được dùng để phân loại văn bản theo tiêu chí lý thuyết, trích xuất thông tin cấu trúc, và mã hóa quy mô lớn.
2.3 Mô Hình Hóa Dựa Trên Tác Nhân — Mô Phỏng Xã Hội Phức Tạp
Mô hình hóa dựa trên tác nhân (Agent-Based Modeling — ABM) là phương pháp trong đó nhà nghiên cứu thiết kế các ‘tác nhân’ với đặc điểm và quy tắc hành vi được chỉ định, đặt họ vào môi trường có cấu trúc, và quan sát các mô hình xã hội nổi lên từ tương tác của họ.
Điểm mạnh đặc biệt của ABM là khả năng nghiên cứu các thuộc tính nổi sinh (emergent properties). Axelrod (1997) trong The Complexity of Cooperation đã dùng ABM để chứng minh rằng hành vi hợp tác có thể tiến hóa trong quần thể tác nhân hoàn toàn ích kỷ thông qua các cơ chế đơn giản như Tit-for-Tat — kết quả có hàm ý sâu sắc cho lý thuyết về hành động tập thể.
2.4 Phân Tích Dữ Liệu Lớn — Quy Mô Như Một Công Cụ Phân Tích
Boyd và Crawford (2012) xác định dữ liệu lớn theo ba V: Volume (khối lượng), Velocity (tốc độ), và Variety (đa dạng). Trong bối cảnh CSS, một thuộc tính thứ tư thường quan trọng hơn: Veracity — tính xác thực và đại diện của dữ liệu.
Nguồn dữ liệu lớn phổ biến: dữ liệu di động điện thoại (call detail records) về di chuyển và mạng lưới xã hội; dữ liệu mạng xã hội về ý kiến và phát tán thông tin; dữ liệu hành chính (hồ sơ y tế, thuế) với độ bao phủ quần thể gần như toàn diện; và dữ liệu vệ tinh về hoạt động kinh tế và biến đổi đất đai.
PHẦN 3: Quy Trình Triển Khai — Từ Thu Thập Đến Diễn Giải
3.1 Thu Thập Dữ Liệu: Web Scraping và API
Web Scraping là kỹ thuật tự động thu thập dữ liệu từ trang web bằng cách phân tích cấu trúc HTML. Trong Python, thư viện BeautifulSoup và Scrapy là công cụ chuẩn. Lưu ý: nhiều trang web cấm scraping trong điều khoản sử dụng, và việc scraping quy mô lớn không có chính sách sử dụng hợp lý có thể vi phạm tinh thần điều khoản sử dụng.
API (Application Programming Interface) là phương thức tiếp cận dữ liệu có cấu trúc hơn: nhà cung cấp cung cấp điểm cuối với quy tắc truy cập rõ ràng và thường có sự chấp thuận tường minh cho mục đích học thuật. Tuy nhiên, sự thay đổi chính sách gần đây của các nền tảng mạng xã hội đã tạo ra những thách thức mới cho khả năng tái lập của nghiên cứu.
3.2 Tiền Xử Lý, Phân Tích, và Diễn Giải
Trong quy trình CSS điển hình, thời gian dành cho tiền xử lý dữ liệu thường chiếm 60–80% tổng thời gian. Dữ liệu thô từ web thường bị thiếu, mâu thuẫn, thiên kiến. Các bước cần thiết: loại bỏ trùng lặp và phát hiện robot, xử lý giá trị thiếu, chuẩn hóa định dạng, và xác thực đại diện.
Giai đoạn diễn giải kết quả trong bối cảnh lý thuyết xã hội là điểm phân biệt CSS với phân tích dữ liệu thuần túy. Một mô hình chủ đề trên 5 triệu tweet không tự nó là khoa học xã hội — nó trở thành khoa học xã hội khi nhà nghiên cứu đặt các chủ đề được phát hiện trong đối thoại với các lý thuyết về nghị trình truyền thông, phát tán ý tưởng, hay phân cực chính trị.
PHẦN 4: Thách Thức EEAT — Đạo Đức, Thiên Kiến, và Tính Đại Diện
4.1 Thiên Kiến Thuật Toán — Vấn Đề Không Thể Bỏ Qua
Thiên kiến thuật toán xảy ra khi một mô hình học máy tái tạo và khuếch đại các thiên kiến trong dữ liệu huấn luyện. Thuật toán không tự ý thiên kiến — chúng phản ánh thiên kiến của dữ liệu, và dữ liệu phản ánh thiên kiến của xã hội và quy trình thu thập.
Ví dụ kinh điển: các mô hình dự đoán tái phạm tội như COMPAS được chứng minh là dự đoán tỷ lệ tái phạm cao hơn không chính xác cho người Mỹ gốc Phi so với người da trắng. Không phải thuật toán có ý định phân biệt — mà là dữ liệu lịch sử về bắt giữ phản ánh sự giám sát không đồng đều giữa các cộng đồng.
Trong nghiên cứu xã hội, thiên kiến biểu hiện tinh tế hơn: mô hình ngôn ngữ được huấn luyện chủ yếu trên văn bản tiếng Anh kém hiệu quả với các ngôn ngữ khác; mô hình trên Twitter không đại diện cho dân số không dùng Twitter. Salganik (2018) trong Bit by Bit gọi đây là vấn đề ‘dữ liệu sẵn có nhưng không đại diện’ — một trong những mối đe dọa lớn nhất cho tính giá trị ngoài của nghiên cứu CSS.
4.2 Nghịch Lý Dữ Liệu Lớn — Và Tại Sao Vẫn Cần Dữ Liệu Sâu
Lazer và Sayeed (2015) với ‘Parable of Google Flu’ minh họa rằng mô hình Big Data của Google dự đoán dịch cúm dựa trên tìm kiếm đã thất bại vì nó bắt được tín hiệu tương quan bề mặt mà không hiểu cơ chế nhân quả cơ bản. CSS ở trạng thái tốt nhất không phải là CSS thay thế phỏng vấn bằng Twitter — mà là CSS dùng dữ liệu lớn để phát hiện các mô hình cần giải thích, sau đó dùng dữ liệu sâu để hiểu cơ chế tạo ra chúng.
4.3 Đạo Đức Nghiên Cứu Trong Kỷ Nguyên Số
Khi nhà nghiên cứu sử dụng dữ liệu công khai từ Twitter, người dùng có đồng ý rằng tweet công khai của họ trở thành dữ liệu nghiên cứu không? Zimmer (2010) lập luận rằng tính công khai về mặt kỹ thuật không đồng nghĩa với đồng ý được thông tin — người đăng tweet công khai không nhất thiết kỳ vọng tweet đó được phân tích và công bố trong tạp chí học thuật.
Nguyên tắc thực hành tốt: ẩn danh hóa dữ liệu ngay cả khi nguồn là công khai; tối thiểu hóa dữ liệu — chỉ thu thập những gì thực sự cần; xem xét nguy cơ tái nhận dạng sau ẩn danh hóa; và minh bạch về nguồn dữ liệu để người phản biện có thể đánh giá.
Kết Luận và Tài Liệu Tham Khảo
CSS đại diện không chỉ cho một tập hợp kỹ thuật mới mà cho sự mở rộng thực sự của năng lực nhận thức trong khoa học xã hội. Nhà nghiên cứu CSS giỏi nhất không phải là người biết nhiều kỹ thuật nhất, mà là người có thể đặt câu hỏi có ý nghĩa lý thuyết, biết khi nào dữ liệu lớn là công cụ phù hợp và khi nào cần dữ liệu sâu hơn, và có kỷ luật để hiểu rằng mô hình khớp với dữ liệu không phải là bằng chứng của hiểu biết về cơ chế.
Tài liệu tham khảo:
Lazer, D., et al. (2009). Computational social science. Science, 323(5915), 721–723.
Boyd, D., & Crawford, K. (2012). Critical questions for big data. Information, Communication & Society, 15(5), 662–679. — Salganik, M. J. (2018). Bit by bit: Social research in the digital age. Princeton University Press.
Axelrod, R. (1997). The complexity of cooperation. Princeton University Press. — Cranmer, S. J., & Desmarais, B. A. (2011). Inferential network analysis with exponential random graph models. Political Analysis, 19(1), 66–86.
Zimmer, M. (2010). But the data is already public. Ethics and Information Technology, 12(4), 313–325.
Trước đây, tôi biết có 2 nhóm phương pháp nghiên cứu chính: Định tính và Định lượng.
Qua bài báo, tôi biết thêm 1 phương pháp nữa: computation method
Ở việt nam chưa có ngành css, ở đâu đào tạo nhỉ? Rất hữu ích cho kỷ nguyên vươn mình của việt nam.
Trước đây tôi cũng nghe loáng thoáng ở đâu đó về css, nhưng không để tâm lắm cho đến khi đọc bài báo của bạn. Ngay sau đó tôi tìm hiểu kỹ hơn và có 1 vài đánh giá (cá nhân):
– Css tất yếu sẽ xuất hiện và phát triển ở việt nam;
– Việc của các nhà khoa học trẻ như bạn là khiến nó đến sớm hơn, nhanh hơn;
– Hãy: tạo trent trên các nền tảng mạng xã hội; những người như bạn (kiến thức, trẻ, tâm huyết) đầu tư học thạc sĩ / tiến sĩ ở những nước mạnh về css (mỹ, tây âu …); về nước, lập nhóm xây css…
Cảm ơn anh đã đọc và có nhận định rất có chiều sâu! Ở Việt Nam mình hiện tại đúng là “vùng trũng” về đào tạo chính quy ngành CSS, chưa có trường nào mở ngành riêng cả. Hiện tại, các bạn trẻ muốn theo đuổi hướng này chủ yếu phải tự bơi bằng cách ghép hai kỹ năng lại: học vững nền tảng xã hội học và tự học thêm các công cụ như Python, R để cào và xử lý dữ liệu lớn.
Xu hướng là định lượng, nhưng về bản chất nghiên cứu KHXH vẫn là định tính